

この記事のポイント(結論を先に)
- User-Agent(名乗り)は自己申告です。誰でも書き換えられる自己申告欄で、サーバー側に真偽を確かめる仕組みはありません(RFC 9110、2022年6月)。
- 確かめ方は2つ。逆引きDNSと、各社が公開するIPレンジ一覧との照合です。Googleは検証手順とIPレンジのJSONを公開しています(Google公式、2026年3月20日更新)。
- 当社サーバーの実測では、3週間で84のIPアドレスから2,944件が正規クローラーを名乗って設定ファイルを探していました。狙い撃ちではなく、片端から試す探索です。
アクセスログに「Googlebot」と並んでいても、本物のGoogleとは限りません。名乗りは自己申告で、誰でも書き換えられます。本物かを確かめる公式手順と、どこまで手を打つべきかの線引きを、当社サーバの実測とあわせて整理します。何が起きていたかは前回の偽ボットのアクセスログを読み解いた記事で扱いました。本記事はその続編です。
結論:名前ではなくIPアドレスで確かめる
- User-Agent(ボットやブラウザが自分の名前を名乗る欄)は、発信元の公式情報と照合する
- 送信元IPを逆引きDNSで調べる、または各社が公開するIPレンジ一覧と照合する
- 403・404の要求はまとめて記録し、同じ時間帯のログイン履歴やファイル変更と合わせて確認する
根拠はHTTPの仕様です。RFC 9110(HTTPの意味を定めた標準、2022年6月)10.1.5節は「ユーザーエージェントは、送らないよう明示的に設定されていない限り、各リクエストでUser-Agentヘッダフィールドを送るべきである」と定めます。送る側が決める欄で、サーバ側に真偽を確かめる仕組みはありません。Google公式も同じ前提です。「Verify Google crawlers and fetchers」(2026年3月20日更新)は、検証手順が「スパマーやその他の迷惑行為者が、Googleを名乗りながらあなたのサイトにアクセスしているのではと心配な場合に役立つ」と説明しています。
なぜ確認が要るのか——当社ログでの実測
当社サイトのログを2026年7月18日から8月7日までの約3週間分、集計しました。User-Agentに正規クローラー名を含むリクエストを抽出し、送信元IPを逆引きして運営元を確かめる方法です。その結果、84のIPアドレスから2,944件が該当しました。逆引きの到達先はクラウド事業者やスキャン業者で、探されていたのは .env や .git といった設定ファイルです。
件数の内訳、応答コードの読み方、どこまでを危険と判断したかは、アクセスログの“不審なアクセス”は危険か|正規ボットになりすます自動スキャンの正体と見分け方で扱っています。本記事では、そのとき使った確認手順だけを取り出して説明します。
見分け方は2通り。逆引きDNSと公開IPレンジ
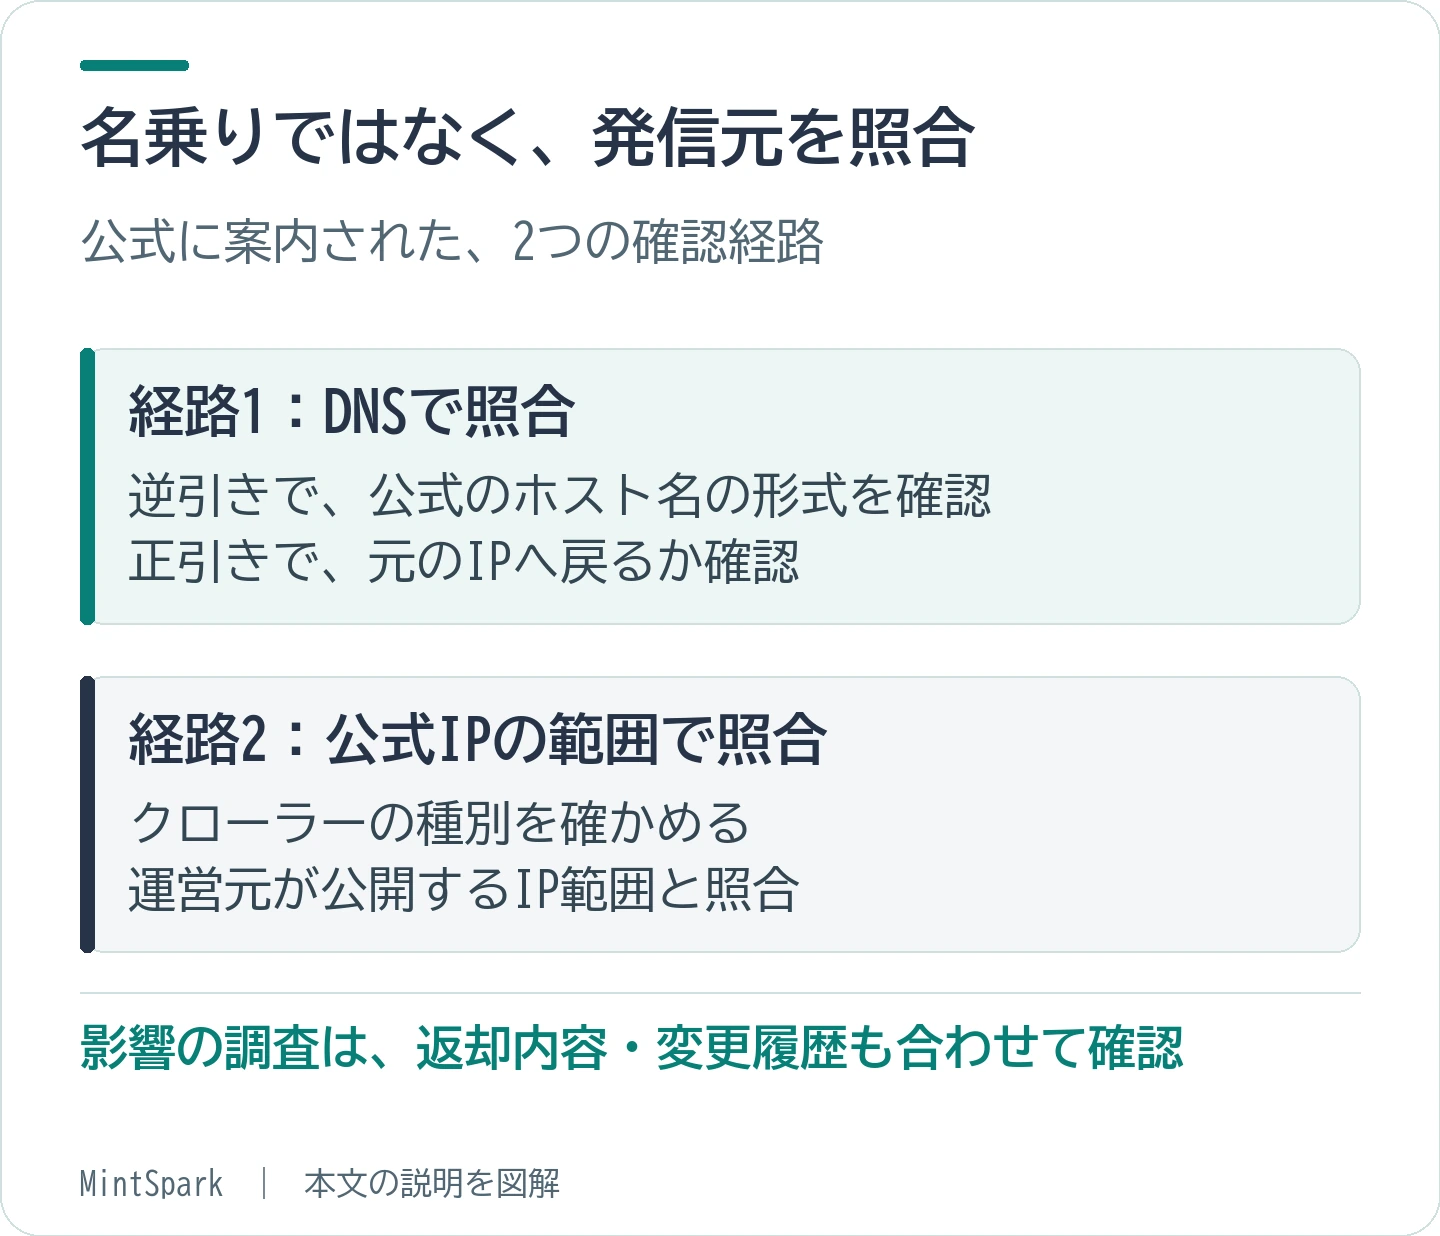
1つ目は逆引きDNSです。IPからホスト名を調べ、得られたホスト名を正引きして元のIPに戻るかを確かめます。Googleの場合は、名乗っているクローラーの種類に対応するホスト名の形式と、公式のIP範囲も照合します。googlebot.comなどの末尾に加え、公式に示された形式まで見ると、名前の似た発信元を取り違えずに済みます。Windowsではnslookupで調べられます。
2つ目は、Googleが公開するIPレンジ一覧との照合です。同ドキュメントは用途別に5つのJSONを示しており、Googlebot など通常のクローラーは common-crawlers.json、ほかに special-crawlers.json、user-triggered-fetchers.json など4種があります。ログのIPが一覧に無ければGoogleではありません。
AIのクローラーも同様です。Anthropic(Claudeの提供元)は自社ボットの送信元IPを claude.com/crawling/bots.json で公開し、公式ヘルプは「クローラーの送信元IPアドレスがこのリストにあれば、そのクローラーはAnthropicから来ていることを示す」と説明しています。同社のボットはClaudeBot(学習向け)、Claude-User(利用者の質問に応じた取得)、Claude-SearchBotの3種です。
社内に技術者がいなければ、制作会社にこう依頼すれば通じます。「User-Agentに主要クローラー名を含むアクセスを抽出し、送信元IPを逆引き+正引きとGoogle公開IPレンジで検証。偽装分の件数・IP数・リクエスト先パス・応答コードを一覧にしてほしい」
放置してよいもの、手を打つべきもの
偽装が見つかっても全件への対処は要りません。判断軸は「相手が何を持ち帰れたか」です。
| ログの状況 | 対応 |
|---|---|
| 404/403。拒否された、または対象が見つからなかった要求 | 要求をまとめて記録。同じ時間帯のログイン履歴やファイル変更も確認 |
| 200。要求に対する応答が返っている | 返却内容を確認。設定ファイルなどの公開が分かったら、公開停止・認証情報変更・ログ保全を進める |
| 逆引き・正引きが一致し、公式のクローラー種別・IP範囲とも一致 | 本物。止めない(誤遮断は検索結果の掲載に影響する) |
| 同一IPが短時間に複数の正規ボット名を名乗る | 名乗りと公式の発信元情報、要求の内容を照合 |
| 件数が多くサーバが重い | WAFやレート制限で全体を絞る |
IP単位の遮断に労力を割きすぎないでください。相手はクラウド上でIPを取り替えられます。Anthropicの公式ヘルプも、IP遮断は「正しく機能しない、または継続的に拒否を保証できない可能性がある」として robots.txt での指定を勧めています。
探索を空振りにさせる考え方
偽装アクセスそのものを止めることはできません。相手は世界中のサイトを片端から試しているだけなので、個別に遮断しても次が来ます。できるのは、探されているものが見つからない状態にしておくことです。
考え方は3つに整理できます。秘密情報を含むファイルを公開ディレクトリの外に置くこと、アップロード領域でのプログラム実行を禁じること、ファイルの権限を必要最小限に絞ることです。いずれも追加の製品を導入せず、設定だけで対応できます。具体的な項目はアクセスログの“不審なアクセス”は危険か|正規ボットになりすます自動スキャンの正体と見分け方にまとめました。
RFC 9110の17.12節に「攻撃者は見かけ上のソフトウェアバージョンにかかわらず、あらゆる潜在的な穴を試す傾向がある」とあります。今回の2,944件も狙い撃ちではなく、片端から試す探索でした。穴が無ければ空振りに終わります。運用面の点検項目は、IPA「安全なウェブサイトの作り方」改訂第7版(2021年3月31日)第2章にまとまっています。
自社サイトが外からどう見えているかは、無料セキュリティ診断で確認できます。URLを入れるだけ・登録不要で、HTTPSやWordPressの情報露出など外部から見える範囲を自動チェックします。ログの読み方や直すべき範囲で迷う場合は、お問い合わせからご相談ください。情報処理安全確保支援士が切り分けをお手伝いします。
参考・出典
- Google「Verify Google crawlers and fetchers」2026年3月20日更新 https://developers.google.com/crawling/docs/crawlers-fetchers/verify-google-requests
- Anthropic ヘルプ(Webクロールとブロック方法)https://privacy.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
- Anthropic 公開IPレンジ https://claude.com/crawling/bots.json
- RFC 9110「HTTP Semantics」IETF 2022年6月(10.1.5節・17.12節)https://www.rfc-editor.org/rfc/rfc9110.html
- WordPress「Hardening WordPress」https://developer.wordpress.org/advanced-administration/security/hardening/
- IPA「安全なウェブサイトの作り方」改訂第7版 2021年3月31日 https://www.ipa.go.jp/security/vuln/websecurity/about.html
参考:httpwg.org(2026年10月12日確認)
この記事に関連するよくある質問
アクセスログのUser-Agentを見れば、正規のクローラーかどうか判断できますか?
判断できません。User-Agent(名乗り)は誰でも書き換えられる自己申告欄で、サーバー側に真偽を確かめる仕組みはありません(RFC 9110)。「Googlebot」と名乗っていても、それだけでは根拠になりません。
正規のクローラーかどうかは、どうやって確かめればよいですか?
2通りあります。アクセス元のIPアドレスを逆引きして正規のホスト名に解決されるかを確認する方法と、各社が公開しているIPレンジの一覧と照合する方法です。Googleは検証手順とIPレンジのJSONを公開しています。
ログに .env や wp-config.php を探すアクセスがありました。危険な状態でしょうか?
アクセスがあること自体は、狙い撃ちされている証拠ではありません。世界中のサイトを片端から試す自動スキャンによるものがほとんどです。問題は、探されているファイルが実際に取得できる状態かどうかです。公開ディレクトリの外に置けていれば、空振りに終わります。